
Gestão de Problemas no Portal Nyverra: RCA, grupos de problemas e KEDB
 Wedson Lopes
Existe uma armadilha silenciosa em todo service desk: resolver o mesmo incidente dez vezes e chamar isso de produtividade. Cada reincidência é tempo perdido, SLA consumido e cliente desgastado — quando a causa raiz continua intacta. É para isso que existe a gestão de problemas.
Este guia explica como o módulo de Problemas do Portal Nyverra ITSM transforma incidentes recorrentes em investigação estruturada: agrupamento, causa raiz (RCA), workarounds, base de erros conhecidos (KEDB) e o encaminhamento da correção definitiva para Mudanças.
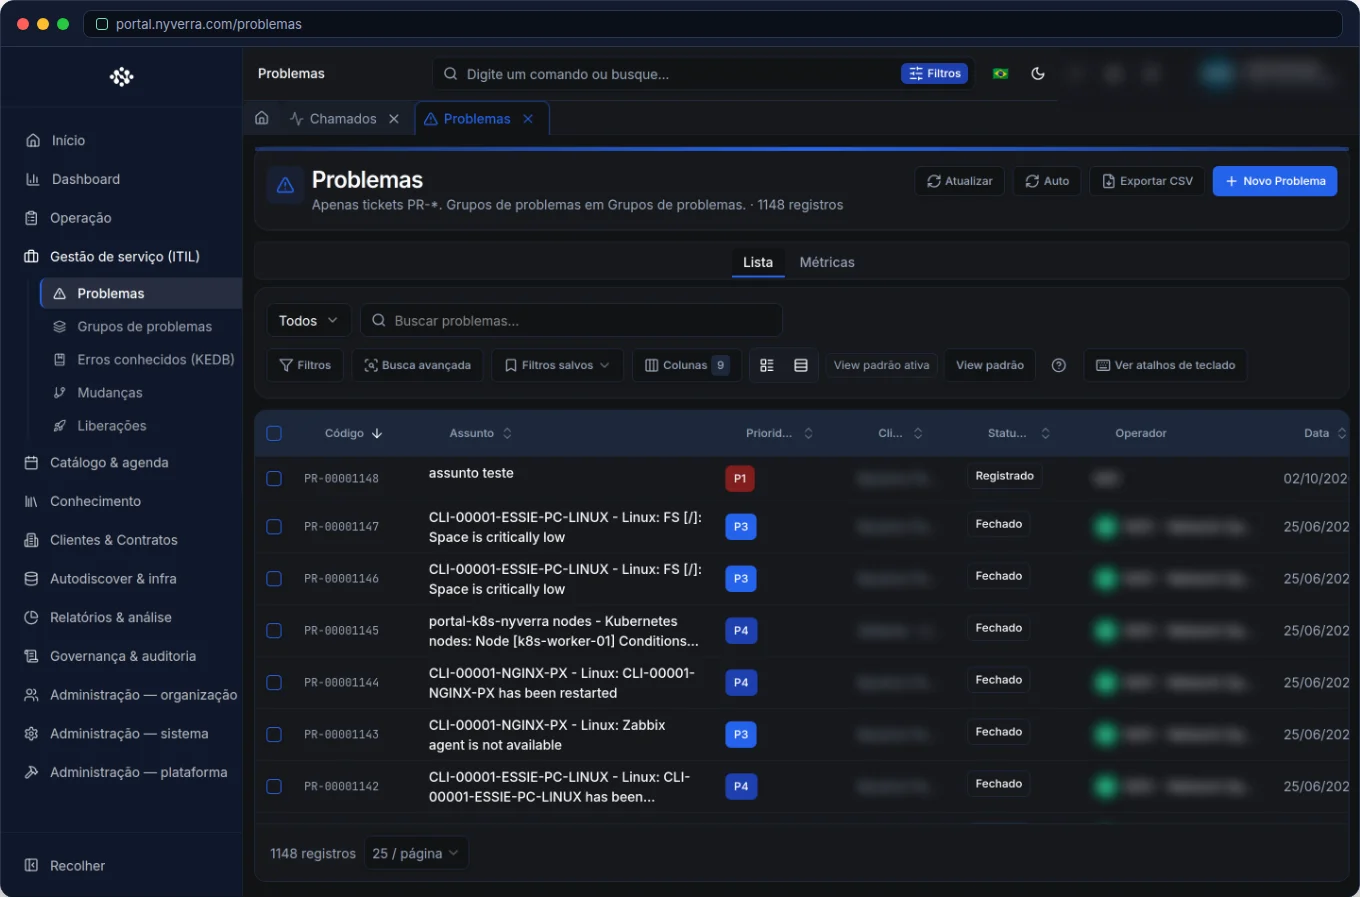 Interface do módulo no Portal Nyverra ITSM.
Problema não é incidente
Confundir os dois conceitos é o erro mais comum — e o mais caro. A distinção, definida pelo ITIL, é direta:
| Incidente | Problema | |
|---|---|---|
| Objetivo | Restaurar o serviço o quanto antes | Eliminar a causa raiz |
| Foco | O sintoma visível agora | O “porquê” por trás dos sintomas |
| Horizonte | Imediato | Investigação ao longo do tempo |
| Métrica | Tempo de resolução | Recorrência eliminada |
Um problema (ticket PR-) é a unidade de investigação que agrupa vários incidentes com o mesmo sintoma. Não é “um chamado mais importante” — é outra disciplina, com ciclo de vida próprio.
Quando abrir um problema
Nem toda falha merece uma investigação formal. Abra um problema quando houver sinais de recorrência ou impacto amplo:
- O mesmo incidente reaparece em intervalos regulares.
- Uma falha afeta vários usuários, serviços ou ativos ao mesmo tempo.
- Existe risco ou custo relevante e ninguém sabe a causa.
- Um incidente maior (major incident) exigiu esforço desproporcional para ser contornado.
Uma boa heurística: se você consegue apontar dois ou mais chamados com o mesmo sintoma, provavelmente há um problema esperando ser criado.
Quem usa
| Perfil | Uso típico |
|---|---|
| Técnico / 2ª e 3ª linha | Investigar, registrar RCA e aplicar workarounds |
| Gestor de serviços | Priorizar problemas, cobrar análise e aprovar mudanças corretivas |
| Operação / NOC | Vincular incidentes a grupos de problemas já conhecidos |
| Cliente | Em geral não acessa esta área |
Os recursos do módulo
Grupos de problemas
São o “caso” que reúne a investigação: uma equipe multidisciplinar, os problemas ligados a ela e os incidentes associados. Em vez de cada analista investigar isolado, o grupo concentra esforço e evidências. O Portal permite criar grupos, gerenciar membros, correlacionar incidentes e acompanhar recorrências e tarefas de investigação.
RCA — análise de causa raiz
É o coração do módulo: o registro estruturado de hipóteses, evidências e da causa raiz confirmada. Uma RCA bem feita responde não só “o que falhou”, mas “por que falhou” e “por que não foi detectado antes”. É esse documento que sustenta a decisão de corrigir de forma definitiva.
Análise de impacto
Conecta o problema aos ativos (CMDB) e serviços de negócio afetados. Assim a prioridade deixa de ser subjetiva: você enxerga o alcance real da falha — quantos clientes, quais serviços, qual criticidade.
Workarounds
Nem sempre a causa é conhecida no dia 1. O workaround é a solução de contorno documentada — um paliativo que devolve o serviço ao ar enquanto a correção definitiva não existe. Workarounds bem escritos aliviam o atendimento imediato e evitam que cada técnico “reinvente” o contorno.
KEDB — base de erros conhecidos
A KEDB (Known Error Database) é o catálogo de erros já diagnosticados, com sintoma, causa e contorno. Quando um incidente chega, a operação consulta a KEDB e aplica o workaround conhecido em segundos. É o ativo que transforma conhecimento individual em capacidade coletiva.
Vínculo com mudanças
A investigação só termina quando a causa é eliminada. O problema se liga a uma mudança (RFC) que implementa a correção definitiva, fechando o ciclo ITIL: incidente → problema → mudança.
Como usar: o fluxo na prática
- Identifique a recorrência: note incidentes com o mesmo sintoma no mesmo serviço ou ativo.
- Crie o problema: registre um
PR-descrevendo sintomas e impacto. - Vincule os incidentes: associe os chamados relacionados ao problema/grupo — eles viram evidência.
- Investigue e documente a RCA: registre hipóteses, testes e a causa raiz.
- Publique o workaround: coloque o contorno na KEDB e na base de conhecimento, para uso imediato.
- Encaminhe a correção: vincule uma mudança e acompanhe até a implantação.
- Feche o problema quando a recorrência for eliminada e valide com os indicadores.
Regras de negócio
| Regra | Explicação |
|---|---|
| Problema ≠ chamado | Chamado é o pedido do usuário; problema é a gestão da causa. |
| Vínculos | Um incidente pode ligar-se a um problema; relatórios mostram o conjunto. |
| Mudança | A correção estrutural costuma gerar um registro em Mudanças. |
| Permissão | Quem não vê Problemas no menu não deve acessar a URL diretamente (RBAC). |
Boas práticas
- Priorize problemas por impacto × número de incidentes vinculados, não por “quem gritou mais alto”.
- Documente o workaround mesmo sem causa raiz conhecida — ele já gera valor imediato.
- Promova erros recorrentes e conhecidos à KEDB para acelerar o primeiro atendimento.
- Revise periodicamente problemas sem atividade e sem prazo definido.
- Ligue cada problema ao ativo do CMDB para revelar padrões por equipamento.
Erros comuns
| Situação | O que fazer |
|---|---|
| Transformar todo incidente em problema | Reserve o módulo para recorrência/impacto; incidentes simples se resolvem como chamados. |
| RCA “caixa-preta” | Documente hipóteses e evidências, não só a conclusão — a auditoria futura agradece. |
| Problema aberto para sempre | Defina prazo e responsável; sem isso, a investigação esfria. |
Perguntas frequentes
Problema substitui o atendimento ao usuário?
Não. O incidente continua sendo resolvido normalmente; o problema corre em paralelo, atacando a causa.
Preciso de causa raiz para criar um problema?
Não. Pode começar com sintomas e workaround; a RCA é o produto da investigação, não o pré-requisito.
Onde o cliente vê o workaround?
O contorno pode ser publicado na base de conhecimento e usado nos trâmites de atendimento.
Automatize via API
Os recursos do módulo estão disponíveis por API REST (/api/problema-grupos, /api/problema-rca, /api/problema-tarefas, /api/workarounds, /api/kedb), permitindo integrar a gestão de problemas a outras ferramentas. A referência está em developer.nyverra.com.
Cenários de uso: onde a gestão de problemas entra
1. VPN cai todos os dias às 9h. A fila recebe, ao longo de duas semanas, dezenas de chamados “não consigo conectar”. Em vez de resolver um a um, a operação cria um problema, vincula os incidentes e investiga o padrão: o pico coincide com o backup da madrugada ainda em execução. A RCA aponta a causa; um workaround (reagendar o backup) alivia imediatamente; uma mudança corrige em definitivo.
2. Impressora de um setor falha por semanas. O mesmo equipamento gera chamados recorrentes. O problema liga-se ao ativo no CMDB — e a análise mostra que o modelo está no fim da vida útil. A decisão deixa de ser “consertar de novo” e passa a ser “substituir”, com dado para justificar o investimento.
3. Instabilidade após deploy. Um serviço degrada toda vez que uma rotina noturna roda. O problema conecta incidentes, RCA, workaround e a mudança que ajusta a rotina — fechando o ciclo ITIL completo.
Como medir a gestão de problemas
| Indicador | O que revela |
|---|---|
| Incidentes vinculados por problema | A escala da recorrência |
| Tempo até a RCA | Velocidade de diagnóstico |
| Problemas com workaround publicado | Alívio imediato enquanto se corrige |
| Recorrência antes/depois | Eficácia da correção definitiva |
| Problemas sem atividade | Investigações esquecidas |
Esses números mudam a conversa da TI com o negócio: em vez de “resolvemos X chamados”, passa-se a “eliminamos a causa de Y% das reincidências”.
Integração com o ecossistema
A gestão de problemas ganha força quando conectada: o monitoramento (Zabbix) alimenta incidentes que revelam padrões; o CMDB mostra onde o problema vive; o Downtime Manager evita alertas falsos durante investigação; e o módulo de Mudanças implementa a correção. Fechar esse ciclo dentro de um só sistema é o que evita que a investigação vire folclore e a correção nunca chegue.
Conclusão
Gestão de problemas é o que separa uma operação reativa de uma operação que aprende. Com grupos de problemas, RCA, workarounds e KEDB integrados ao CMDB e às mudanças, o Portal Nyverra ITSM reduz a reincidência de falhas, libera a equipe do retrabalho e eleva a maturidade do service desk — exatamente o que cobram os frameworks ITIL e ISO 20000.
Continuar a ler
Leia também
 Portal ITSM
Chegou o app mobile do Portal Nyverra ITSM — e todo o ITSM agora cabe no seu bolso
O Portal Nyverra ITSM ganhou um aplicativo Android: chamados, aprovações, dashboard e os módulos do seu service desk na palma da mão, com biometria, modo offline e notificações push. E agora também publicamos a documentação de cada módulo. Veja por onde começar.
3 min de leitura Tutoriais
Portal Nyverra ITSM: visão geral dos módulos e por onde começar
O Portal Nyverra ITSM reúne atendimento, ITIL, CMDB, catálogo, relatórios e governança em uma plataforma só. Neste guia, você entende o mapa dos módulos e por onde começar.
2 min de leitura Tutoriais
Feedback e Reportes de Bug no Portal Nyverra: melhoria contínua com quem usa
Quem usa encontra o que o laboratório não vê. O módulo de Feedback do Portal Nyverra ITSM recebe reportes de bug e sugestões, acompanha o status e transforma a percepção do usuário em backlog priorizado — fechando o ciclo de melhoria contínua.
5 min de leitura
Comentários
Ainda sem comentários
Seja o primeiro a compartilhar sua opinião sobre este artigo.
Deixe um comentário