

Casi todo problema de service desk nace en el mismo punto: el ticket. Es por él que entra la demanda, es en él que el reloj del SLA comienza a correr y es en él que la operación necesita demostrar, al final, lo que se hizo. Un ticket mal registrado genera retrabajo, SLA incumplido y cliente insatisfecho; un ticket bien gestionado es la diferencia entre “apagar incendios” y operar con método.
Esta guía recorre el módulo de Tickets del Portal Nyverra ITSM de principio a fin: qué es (y qué no es) un ticket, cómo funciona el triaje, el cálculo de prioridad y SLA, los trámites internos y públicos, transferencia y escalado, aprobaciones, observadores y las acciones en masa. Al final tendrá el mapa completo del flujo — del registro al cierre.
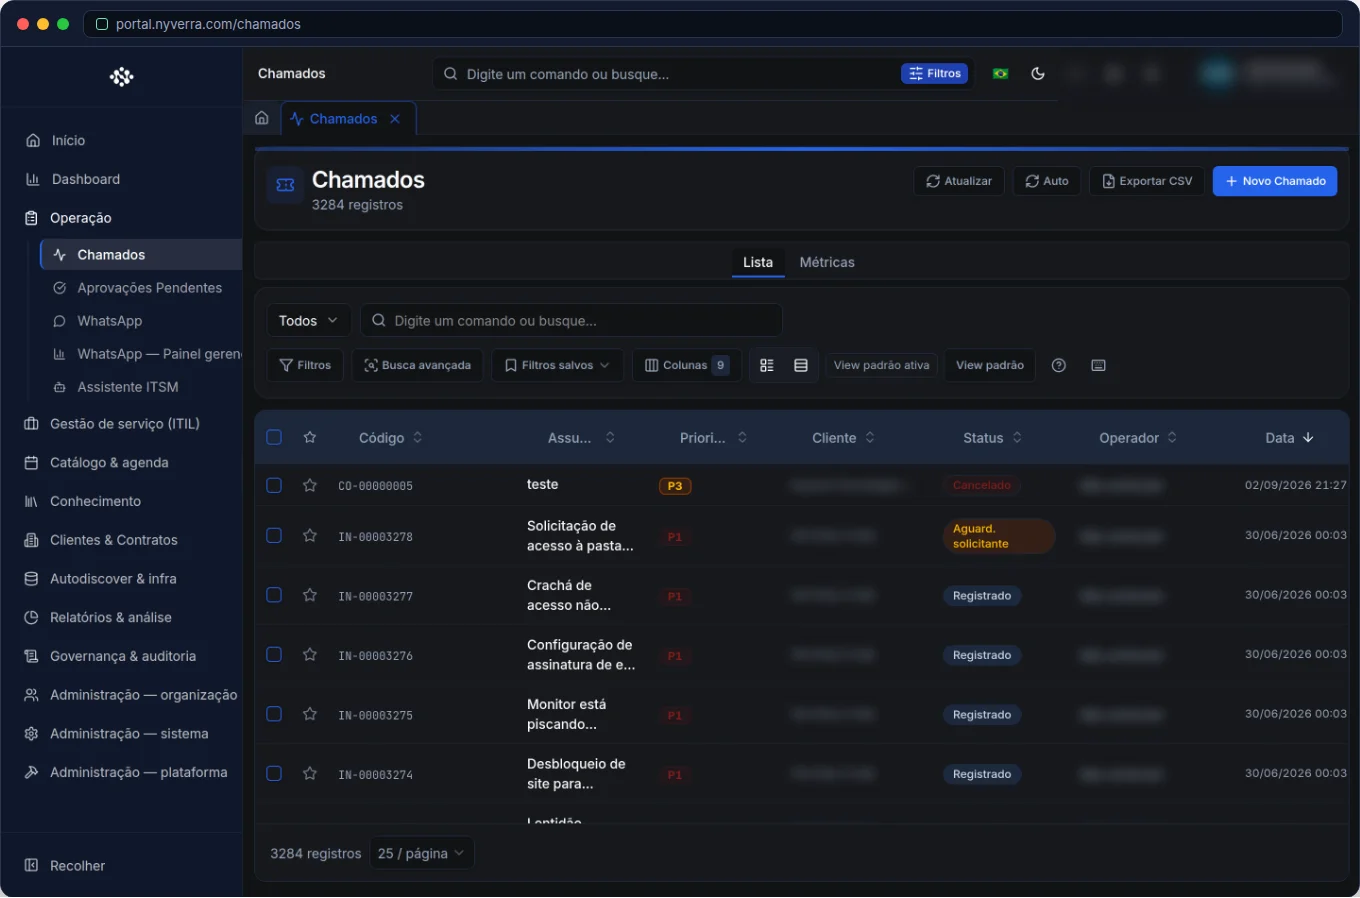 Interfaz del módulo en el Portal Nyverra ITSM.
Qué es un ticket — y qué no lo es
En el Portal, un ticket es un ticket numerado (prefijos como IN- para incidentes y RS- para solicitudes) que lleva solicitante, cliente, clasificación, responsable, plazo y todo el historial de interacciones. Es importante no confundir los conceptos de ITIL:
| Concepto | Objetivo | Ejemplo |
|---|---|---|
| Incidente | Restaurar un servicio que se detuvo o degradó | “El correo de la dirección está caído” |
| Solicitud | Atender una solicitud estandarizada | “Necesito acceso a la carpeta X” |
| Problema | Eliminar la causa raíz de incidentes recurrentes | “La VPN se cae todos los días a las 9h” |
| Cambio | Cambiar algo en producción con control y riesgo | “Actualizar el ERP a la versión 12” |
El ticket resuelve el ahora. Cuando la demanda se repite, debe evolucionar a Problema; cuando exige un cambio planificado, a Cambio. El Portal permite encadenar este flujo dentro del propio ticket, vinculando tickets a problemas, cambios y tickets hijos.
Quién lo usa: perfiles y visibilidad
La visibilidad está controlada por RBAC (control de acceso por roles). El mismo ticket se ve de manera diferente según el perfil:
| Perfil | Qué ve y hace |
|---|---|
| Cliente | Abre y acompaña solo los tickets de su alcance; no ve notas internas. |
| Técnico / operador | Lista, captura, transfiere, registra trámites, controla tiempo y cierra, según permisos (ver todos, del grupo o asignados). |
| Administrador | Configura tipos, categorías, urgencias, impactos, reglas de SLA, calendario y la vista predeterminada por equipo. |
El ciclo de vida de un ticket
El Portal trabaja con estados estándar del flujo — y cada transición tiene consecuencias en el SLA y en las notificaciones:
| Estado | Significado | Impacto en el SLA |
|---|---|---|
| REGISTRADO | Acaba de ser creado, aún en la cola de triaje. | Reloj corriendo desde la creación. |
| EN_ATENCIÓN | Hay un responsable trabajando en el ticket. | Reloj corriendo. |
| PENDIENTE | Esperando a terceros (cliente, proveedor). | Pausa el SLA automáticamente. |
| RESUELTO | Solución aplicada; espera confirmación/cierre. | SLA de resolución cumplido. |
| CERRADO | Ciclo cerrado. | Fin del ciclo. |
| CANCELADO | La demanda no procede o fue cancelada. | Fin del ciclo. |
Cuando un ticket entra en PENDIENTE (por ejemplo, “esperando al cliente”), el Portal congela el reloj del SLA y lo reanuda cuando el estado cambia de nuevo — evitando que el equipo sea penalizado por dependencias externas. Este detalle es uno de los que más impacta los indicadores de cumplimiento.
Apertura y triaje
Crear bien es la mitad del servicio. En la apertura, el Portal captura:
- Solicitante: un usuario de la operación o un contacto del cliente.
- Cliente y, cuando corresponda, ubicación/sucursal.
- Clasificación: tipo de ticket, categoría/área (p. ej., Infraestructura Linux, NOC, Aplicaciones) y subcategoría.
- Asunto y descripción — cuanto mejor se describa el síntoma, más rápido el diagnóstico.
- Urgencia e impacto — que combinados definen la prioridad.
- Vínculos: activo (CMDB), proveedor, ticket relacionado (padre) y tipo de relación.
- Observadores — quién debe recibir los avisos del ticket.
- Adjuntos desde la creación y campos personalizados por categoría.
El triaje es el momento de enrutar: la lista organiza los tickets por plazo y prioridad, y el operador dirige al grupo correcto. Una clasificación consistente es lo que permite informes confiables y la sugerencia automática de categoría por IA.
Prioridad: urgencia × impacto
La prioridad no es subjetiva: surge del cruce entre urgencia (cuánto duele ahora) e impacto (cuántas personas/servicios son afectados). Un incidente que afecta a toda la empresa es prioridad máxima aunque sea técnicamente simple; una solicitud individual es de bajo impacto, por más “urgente” que parezca al solicitante. La matriz de priorización estándar de ITIL:
| Impacto ↓ / Urgencia → | Alta | Media | Baja |
|---|---|---|---|
| Alto | Crítica (P1) | Alta (P2) | Media (P3) |
| Medio | Alta (P2) | Media (P3) | Baja (P4) |
| Bajo | Media (P3) | Baja (P4) | Baja (P4) |
La prioridad resultante define qué reglas de SLA se aplican al ticket.
SLA: qué se mide y cuándo pausa
El Portal controla dos hitos principales: primera respuesta y resolución. Los plazos se calculan por tipo + prioridad, considerando el calendario comercial configurado (horario de atención y feriados — por eso un ticket abierto el viernes por la noche no “vence” el fin de semana).
- Pausa automática: en PENDIENTE, el SLA se congela y se reanuda al salir del estado.
- Alerta de vencimiento: el operador ve el tiempo restante en el detalle; el panel de SLA/OLA evidencia violaciones por cola.
- Visibilidad: técnicos y gestores acompañan el tiempo restante; el cliente ve el estado sin la exposición interna.
Un SLA “extraño” casi siempre tiene una de estas causas: ticket pausado (esperando al cliente), calendario diferente al esperado, o regla de SLA específica del tipo de ticket. Vale la pena consultar con el administrador antes de abrir un incidente sobre el propio SLA.
La cola y la búsqueda
Los tickets maduros viven de filtros. La lista del Portal ofrece filtros rápidos (Todos, Míos, Mi cola, Abiertos, Sin operador) y un panel con estado, prioridad, cliente y período. Todo esto es la base de la vista predeterminada: aquella combinación de filtros que hace que la pantalla se abra ya en la cola que cada equipo atiende. Cuando el administrador define la vista de un perfil, el usuario no la elimina por su cuenta — garantiza consistencia operativa.
Atención: capturar y registrar trámites
Con el ticket en mano, el operador captura el ticket para asumir la responsabilidad y pasa a registrar trámites. Aquí hay una separación que confunde a mucha gente — y que el Portal deja explícita:
| Tipo | Quién lo ve | Cuándo usar |
|---|---|---|
| Nota (interna) | Solo el equipo | Contexto técnico, hipótesis, pasos de diagnóstico, escalado interno. |
| Respuesta (pública) | Solicitante/cliente | Comunicación oficial, pedido de información, aviso de resolución. |
Elegir el tipo correcto evita la vergüenza de exponer al cliente una conversación interna — y evita dejar al cliente sin respuesta por creer que la nota bastaba. Además de los trámites, el operador puede adjuntar archivos y registrar tiempo trabajado (seguimiento de tiempo), cuando el módulo está en uso.
Asignación, transferencia y escalado
Tres operaciones distintas, con propósitos distintos:
- Asignar: definir un operador responsable del ticket.
- Transferir: mover el ticket a otro grupo (y, opcionalmente, un operador destino), informando el motivo — que queda registrado en el historial. Use Transferir cuando la demanda pertenece a otra cola; no use “Editar” solo para cambiar cola o responsable.
- Escalar / Desescalar: subir el nivel de atención (N1 → N2 → N3) cuando exige especialización, y bajar cuando retorna. El historial de escalados preserva niveles de origen/destino, motivo, operador y tiempo empleado.
Estas operaciones respetan permisos: si el botón de transferir aparece deshabilitado, normalmente es falta de permiso (TICKET_UPDATE_*) o el ticket ya está finalizado.
Observadores, aprobaciones y relacionados
- Observadores (CC): personas que siguen el ticket y reciben avisos, sin ser responsables — útil para supervisores y stakeholders.
- Aprobaciones: si el tipo de ticket exige aprobación, el flujo no avanza hasta que los aprobadores decidan. La decisión queda en Aprobaciones pendientes (con contadores/badges).
- Relacionados: vincule el ticket a problemas (recurrencia), cambios (corrección planificada) y tickets hijos/derivados — reconstruyendo el contexto del incidente.
Acciones en masa y exportación
Para demandas en lote, el Portal permite selección múltiple y acciones en masa: cerrar, asignar y cambiar el estado de varios tickets a la vez, con un resumen de éxitos y fallos por ticket. La exportación (Excel/PDF, según permiso) apoya la rendición de cuentas y la revisión de colas.
Notificaciones
Eventos relevantes — nuevo trámite, asignación, decisión de aprobación — disparan notificaciones in-app (campana en el encabezado) y, cuando está configurado, por correo electrónico, chat y push en la app móvil. Quien está en primera línea percibe el cambio sin necesidad de actualizar la pantalla.
Buenas prácticas que cambian el indicador
- Estandarice la clasificación: tipos, categorías y subcategorías consistentes habilitan informes, SLA correctos e IA de sugerencia.
- Separe nota de respuesta: comunicación clara con el cliente, contexto rico para el equipo.
- No deje tickets huérfanos: capture o asigne responsable aún en el triaje.
- Vincule el activo (CMDB): tickets ligados al CI permiten identificar recurrencia por equipo.
- Use la vista predeterminada: el equipo abre ya en la cola correcta, reduciendo el tiempo de triaje.
- Acompañe el SLA por cola: actúe antes del vencimiento, no después.
Errores comunes (y cómo resolverlos)
| Situación | Qué hacer |
|---|---|
| No encuentro el ticket en la lista | Revise los filtros; pruebe “Míos” y “Mi cola”; confirme cliente y estado. |
| Botón Transferir deshabilitado | Confirme permiso y si el ticket no está finalizado. |
| El SLA parece incorrecto | Verifique si está pausado (esperando al cliente) y confirme calendario/regla con el admin. |
| Necesito aprobar algo | Use Aprobaciones pendientes, no solo el detalle del ticket. |
| El cliente “no recibió” la respuesta | Confirme si se registró como Respuesta (pública) y no como Nota (interna). |
Preguntas frecuentes
¿Cuál es la diferencia entre resolver y cerrar?
“Resuelto” indica que la solución fue aplicada; “Cerrado” cierra de hecho el ciclo, normalmente después de la confirmación del cliente o plazo de auto-cierre.
¿El cliente ve los trámites internos?
No. Las Notas son siempre internas; las Respuestas son siempre visibles para el solicitante.
¿Puedo cambiar el tipo de un ticket ya abierto?
Dependiendo del permiso y la política, sí — pero el cambio puede disparar un nuevo SLA o una nueva etapa de aprobación. Úselo con criterio.
¿Cómo evita el Portal un SLA injusto?
Pausando el reloj cuando el ticket espera a terceros (estado PENDIENTE) y respetando el calendario comercial.
Automatice vía API
El módulo de Tickets está expuesto por una API REST. Los recursos más utilizados en integraciones:
GET /api/tickets/busca-avancada— listado con filtros y paginación.POST /api/tickets— apertura de ticket.GET /api/tickets/{id}— detalle.POST /api/tickets/{id}/tramites— añadir trámite.POST /api/tickets/{id}/acoes— capturar/iniciar/cerrar/cancelar.POST /api/tickets/{id}/transferir,/escalare/desescalar.POST /api/tickets/bulk-action— acciones en masa.
La referencia interactiva está en developer.nyverra.com.
Conclusión
El módulo de Tickets del Portal Nyverra ITSM transforma la rutina del service desk en un flujo controlado y auditable: clasificación consistente, prioridad calculada, SLA con pausa automática, comunicación separada entre equipo y cliente, transferencia y escalado rastreables, aprobaciones y acciones en masa. Es la diferencia entre reaccionar y operar con previsibilidad — y el cliente lo percibe.
Seguir leyendo
Lea también
 Tutoriais
Manual LSI / Broadcom MegaRAID — MegaCli y StorCLI
Con esta guía, su equipo gana autonomía para diagnosticar rebuilds, resolver foreign configurations, gestionar BBU y CacheCade — con escenarios reales de producción documentados.
20 min de leitura
Nginx Cheatsheet
Guía de bolsillo con ejemplos listos para configurar Nginx en producción: desde instalación y virtual hosts hasta ajuste de rendimiento y resolución de problemas.
12 min de leitura Kubernetes
Curso Kubernetes 27 — SLO/SLI, on-call y postmortem sin culpa
Qué prometer, cómo medir y qué hacer cuando el error se dispara: SLI, SLO, presupuesto de error, alertas que despiertan a alguien y postmortem sin caza de brujas.
5 min de leitura
Comentarios
Aún sin comentarios
Sea el primero en compartir su opinión sobre este artículo.

Deje un comentario