

Existe una trampa silenciosa en todo service desk: resolver el mismo incidente diez veces y llamar a eso productividad. Cada reincidencia es tiempo perdido, SLA consumido y cliente desgastado, cuando la causa raíz sigue intacta. Para eso existe la gestión de problemas.
Esta guía explica cómo el módulo de Problemas del Portal Nyverra ITSM transforma incidentes recurrentes en investigación estructurada: agrupación, causa raíz (RCA), workarounds, base de errores conocidos (KEDB) y el encaminamiento de la corrección definitiva hacia Cambios.
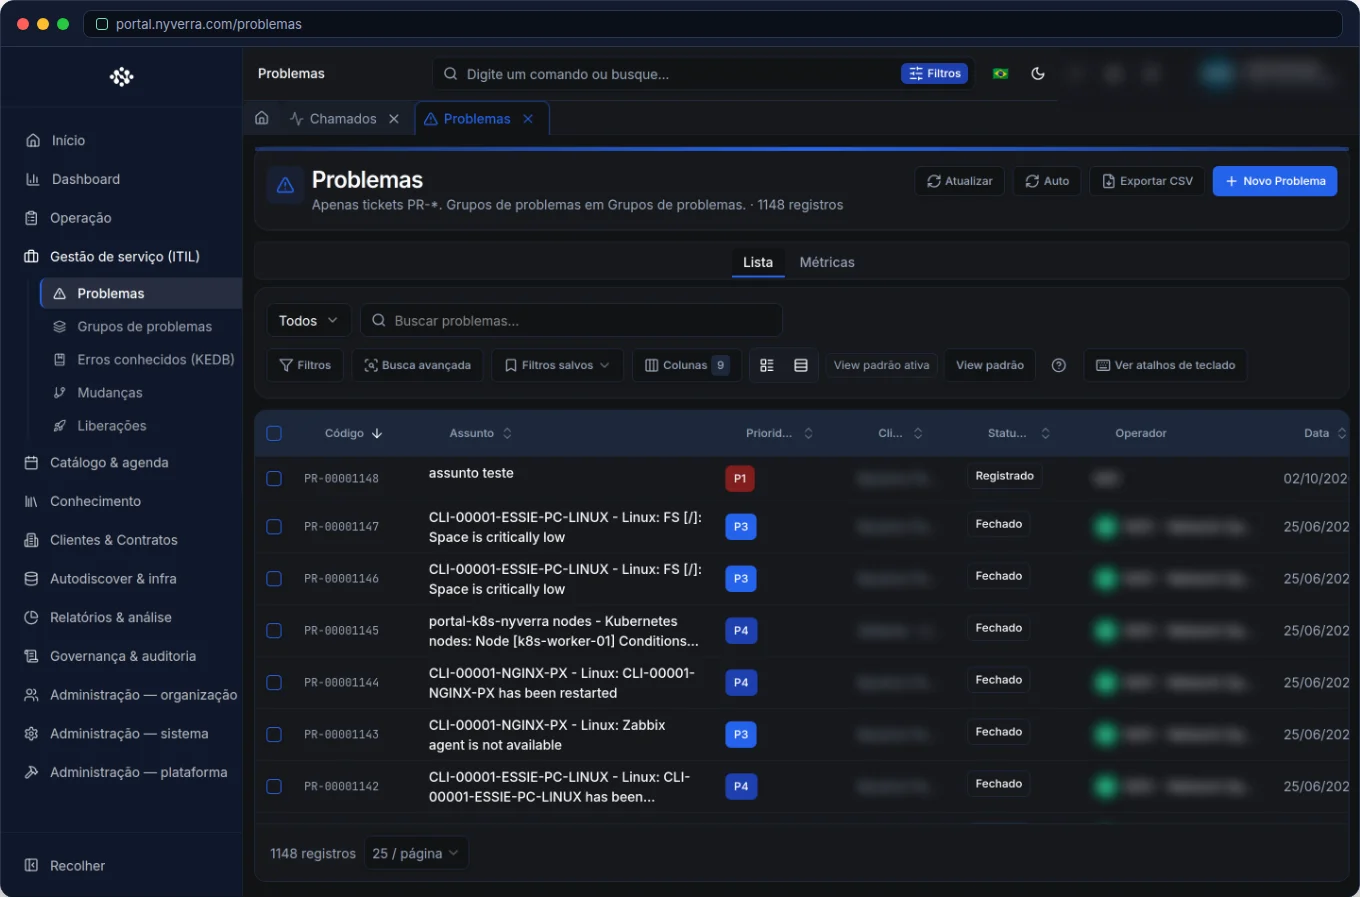 Interfaz del módulo en el Portal Nyverra ITSM.
Problema no es incidente
Confundir los dos conceptos es el error más común, y el más caro. La distinción, definida por ITIL, es directa:
| Incidente | Problema | |
|---|---|---|
| Objetivo | Restaurar el servicio lo antes posible | Eliminar la causa raíz |
| Foco | El síntoma visible ahora | El “porqué” detrás de los síntomas |
| Horizonte | Inmediato | Investigación a lo largo del tiempo |
| Métrica | Tiempo de resolución | Recurrencia eliminada |
Un problema (ticket PR-) es la unidad de investigación que agrupa varios incidentes con el mismo síntoma. No es “un ticket más importante”, es otra disciplina, con ciclo de vida propio.
Cuándo abrir un problema
No toda falla merece una investigación formal. Abra un problema cuando haya señales de recurrencia o impacto amplio:
- El mismo incidente reaparece en intervalos regulares.
- Una falla afecta a varios usuarios, servicios o activos al mismo tiempo.
- Existe riesgo o costo relevante y nadie conoce la causa.
- Un incidente mayor (major incident) exigió un esfuerzo desproporcional para ser resuelto provisionalmente.
Una buena heurística: si puede identificar dos o más tickets con el mismo síntoma, probablemente hay un problema esperando ser creado.
Quién lo usa
| Perfil | Uso típico |
|---|---|
| Técnico / 2.ª y 3.ª línea | Investigar, registrar RCA y aplicar workarounds |
| Gestor de servicios | Priorizar problemas, exigir análisis y aprobar cambios correctivos |
| Operación / NOC | Vincular incidentes a grupos de problemas ya conocidos |
| Cliente | En general no accede a esta área |
Los recursos del módulo
Grupos de problemas
Son el “caso” que reúne la investigación: un equipo multidisciplinario, los problemas vinculados a él y los incidentes asociados. En lugar de que cada analista investigue de forma aislada, el grupo concentra esfuerzo y evidencias. El Portal permite crear grupos, gestionar miembros, correlacionar incidentes y dar seguimiento a recurrencias y tareas de investigación.
RCA — análisis de causa raíz
Es el corazón del módulo: el registro estructurado de hipótesis, evidencias y de la causa raíz confirmada. Una RCA bien hecha responde no solo “qué falló”, sino “por qué falló” y “por qué no se detectó antes”. Es ese documento el que respalda la decisión de corregir de forma definitiva.
Análisis de impacto
Conecta el problema con los activos (CMDB) y los servicios de negocio afectados. Así la prioridad deja de ser subjetiva: se ve el alcance real de la falla — cuántos clientes, qué servicios, qué criticidad.
Workarounds
No siempre se conoce la causa el día 1. El workaround es la solución de contorno documentada — un paliativo que devuelve el servicio al aire mientras no exista la corrección definitiva. Los workarounds bien escritos alivian la atención inmediata y evitan que cada técnico “reinvente” el contorno.
KEDB — base de errores conocidos
La KEDB (Known Error Database) es el catálogo de errores ya diagnosticados, con síntoma, causa y contorno. Cuando llega un incidente, la operación consulta la KEDB y aplica el workaround conocido en segundos. Es el activo que transforma el conocimiento individual en capacidad colectiva.
Vínculo con cambios
La investigación solo termina cuando se elimina la causa. El problema se vincula a un cambio (RFC) que implementa la corrección definitiva, cerrando el ciclo ITIL: incidente → problema → cambio.
Cómo usar: el flujo en la práctica
- Identifique la recurrencia: note incidentes con el mismo síntoma en el mismo servicio o activo.
- Cree el problema: registre un
PR-describiendo síntomas e impacto. - Vincule los incidentes: asocie los tickets relacionados al problema/grupo; se convierten en evidencia.
- Investigue y documente la RCA: registre hipótesis, pruebas y la causa raíz.
- Publique el workaround: coloque el contorno en la KEDB y en la base de conocimientos, para uso inmediato.
- Encamine la corrección: vincule un cambio y haga seguimiento hasta la implementación.
- Cierre el problema cuando se elimine la recurrencia y valide con los indicadores.
Reglas de negocio
| Regla | Explicación |
|---|---|
| Problema ≠ ticket | El ticket es la solicitud del usuario; el problema es la gestión de la causa. |
| Vínculos | Un incidente puede vincularse a un problema; los informes muestran el conjunto. |
| Cambio | La corrección estructural suele generar un registro en Cambios. |
| Permiso | Quien no ve Problemas en el menú no debe acceder a la URL directamente (RBAC). |
Buenas prácticas
- Priorice los problemas por impacto × número de incidentes vinculados, no por “quién gritó más fuerte”.
- Documente el workaround incluso sin causa raíz conocida: ya genera valor inmediato.
- Promueva errores recurrentes y conocidos a la KEDB para acelerar la primera atención.
- Revise periódicamente los problemas sin actividad y sin plazo definido.
- Vincule cada problema al activo del CMDB para revelar patrones por equipo.
Errores comunes
| Situación | Qué hacer |
|---|---|
| Convertir todo incidente en problema | Reserve el módulo para recurrencia/impacto; los incidentes simples se resuelven como tickets. |
| RCA “caja negra” | Documente hipótesis y evidencias, no solo la conclusión; la auditoría futura lo agradecerá. |
| Problema abierto para siempre | Defina plazo y responsable; sin eso, la investigación se enfría. |
Preguntas frecuentes
¿El problema sustituye la atención al usuario?
No. El incidente se sigue resolviendo con normalidad; el problema avanza en paralelo, atacando la causa.
¿Necesito la causa raíz para crear un problema?
No. Puede empezar con síntomas y workaround; la RCA es el producto de la investigación, no el prerrequisito.
¿Dónde ve el cliente el workaround?
El contorno puede publicarse en la base de conocimientos y usarse en los trámites de atención.
Automatice mediante API
Los recursos del módulo están disponibles a través de API REST (/api/problema-grupos, /api/problema-rca, /api/problema-tarefas, /api/workarounds, /api/kedb), lo que permite integrar la gestión de problemas con otras herramientas. La referencia está en developer.nyverra.com.
Escenarios de uso: dónde entra la gestión de problemas
1. La VPN se cae todos los días a las 9:00. La cola recibe, a lo largo de dos semanas, decenas de tickets de “no puedo conectarme”. En lugar de resolver uno a uno, la operación crea un problema, vincula los incidentes e investiga el patrón: el pico coincide con el backup de madrugada aún en ejecución. La RCA señala la causa; un workaround (reprogramar el backup) alivia de inmediato; un cambio corrige de forma definitiva.
2. La impresora de un sector falla durante semanas. El mismo equipo genera tickets recurrentes. El problema se vincula al activo en el CMDB, y el análisis muestra que el modelo está al final de su vida útil. La decisión deja de ser “reparar de nuevo” y pasa a ser “reemplazar”, con datos para justificar la inversión.
3. Inestabilidad después del despliegue. Un servicio se degrada cada vez que se ejecuta una rutina nocturna. El problema conecta incidentes, RCA, workaround y el cambio que ajusta la rutina, cerrando el ciclo ITIL completo.
Cómo medir la gestión de problemas
| Indicador | Qué revela |
|---|---|
| Incidentes vinculados por problema | La escala de la recurrencia |
| Tiempo hasta la RCA | Velocidad de diagnóstico |
| Problemas con workaround publicado | Alivio inmediato mientras se corrige |
| Recurrencia antes/después | Eficacia de la corrección definitiva |
| Problemas sin actividad | Investigaciones olvidadas |
Estas cifras cambian la conversación de TI con el negocio: en lugar de “resolvimos X tickets”, se pasa a “eliminamos la causa del Y% de las reincidencias”.
Integración con el ecosistema
La gestión de problemas gana fuerza cuando está conectada: el monitoreo (Zabbix) alimenta incidentes que revelan patrones; el CMDB muestra dónde vive el problema; el Downtime Manager evita alertas falsas durante la investigación; y el módulo de Cambios implementa la corrección. Cerrar ese ciclo dentro de un solo sistema es lo que evita que la investigación se convierta en folklore y la corrección nunca llegue.
Conclusión
La gestión de problemas es lo que separa una operación reactiva de una operación que aprende. Con grupos de problemas, RCA, workarounds y KEDB integrados al CMDB y a los cambios, el Portal Nyverra ITSM reduce la recurrencia de fallas, libera al equipo del retrabajo y eleva la madurez del service desk, exactamente lo que exigen los marcos ITIL e ISO 20000.
Seguir leyendo
Lea también
 Armazenamento
Manual LSI / Broadcom MegaRAID — MegaCli y StorCLI
Con esta guía, su equipo gana autonomía para diagnosticar rebuilds, resolver foreign configurations, gestionar BBU y CacheCade — con escenarios reales de producción documentados.
20 min de leitura
Nginx Cheatsheet
Guía de bolsillo con ejemplos listos para configurar Nginx en producción: desde instalación y virtual hosts hasta ajuste de rendimiento y resolución de problemas.
12 min de leitura Kubernetes
Curso Kubernetes 27 — SLO/SLI, on-call y postmortem sin culpa
Qué prometer, cómo medir y qué hacer cuando el error se dispara: SLI, SLO, presupuesto de error, alertas que despiertan a alguien y postmortem sin caza de brujas.
5 min de leitura
Comentarios
Aún sin comentarios
Sea el primero en compartir su opinión sobre este artículo.

Deje un comentario