

Existe un ladrón silencioso de productividad en toda operación de TI: la tarea repetitiva. Clasificar, asignar, cambiar prioridad, avisar al gestor — hechas a mano, cientos de veces por semana. El módulo de Automatización del Portal Nyverra ITSM existe para devolver ese tiempo al equipo.
Esta guía explica cómo funcionan las reglas, qué se puede automatizar, cómo hacer seguimiento de las ejecuciones y dónde entra el diseñador visual.
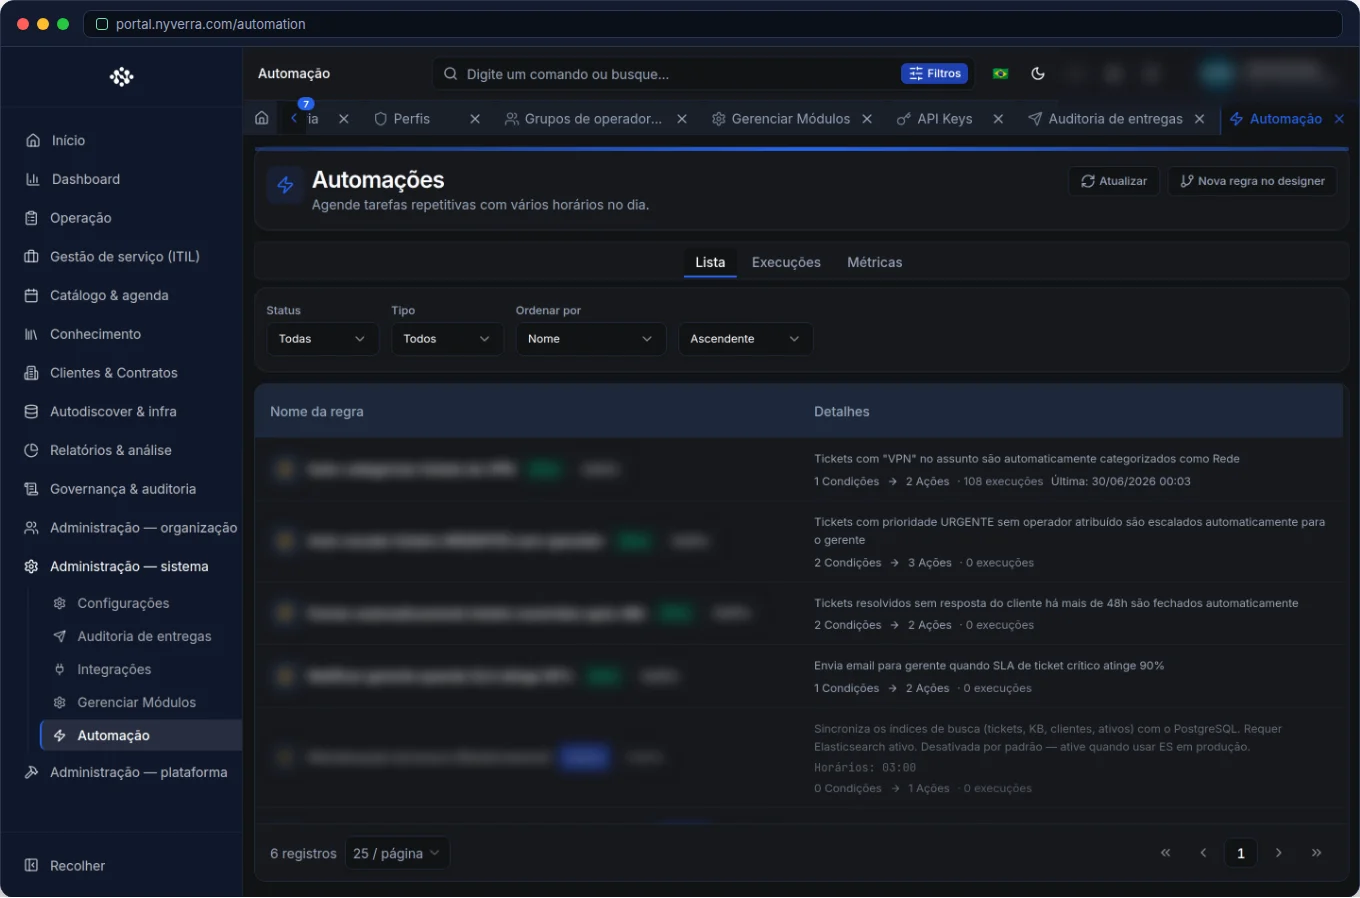 Interfaz del módulo en el Portal Nyverra ITSM.
Qué es una regla de automatización
Es una instrucción condición → acción. El motor observa eventos en el Portal y, cuando la condición se cumple, ejecuta una o más acciones — sin intervención humana. Es el “si esto, entonces aquello” aplicado a la atención.
| Condición (ejemplos) | Acción (ejemplos) |
|---|---|
| Ticket creado en la categoría “Red” | Asignar al grupo de Red |
| Urgencia “Crítica” | Notificar al gestor y aplicar SLA prioritario |
| Solicitud de acceso | Iniciar flujo de aprobación |
| Estado cambiado a “Pendiente” | Pausar SLA y avisar al solicitante |
Qué se puede automatizar
- Enrutamiento: encaminar por categoría, tipo, cliente o urgencia.
- Prioridad: definir/ajustar prioridad automáticamente.
- Notificaciones: avisar a las personas correctas en cada evento.
- Flujos: iniciar aprobaciones o tareas estándar.
- Higiene: reglas de seguimiento y recordatorios.
Gestión de las reglas
| Operación | Qué hace |
|---|---|
| Activar/desactivar | Enciende/apaga una regla sin borrarla |
| Duplicar | Clona una regla como base para otra |
| Eliminar | Elimina la regla |
| Historial de ejecuciones | Muestra cuándo y cómo se disparó la regla |
El historial de ejecuciones es lo que transforma la automatización de “caja negra” en herramienta confiable: ves lo que la regla hizo y cuándo.
Diseñador visual y dry-run
Las reglas simples caben en una línea. Para flujos más elaborados, hay un diseñador visual (editor de reglas), útil para orquestar múltiples condiciones y acciones. Y, siempre que sea posible, lo ideal es probar (dry-run / prueba con un caso real) antes de dejar la regla activa en producción.
Quién lo usa
| Perfil | Uso |
|---|---|
| Administrador | Crear, probar y mantener reglas |
| Gestor de servicios | Definir las políticas que implementa la automatización |
Cómo usar: paso a paso
- Identifique tareas repetitivas (enrutamiento, prioridad, avisos).
- Cree la regla (condición + acciones).
- Pruebe con un caso real antes de activar.
- Active y haga seguimiento del historial de ejecuciones.
- Ajuste según el comportamiento real.
Reglas de negocio y cuidados
| Punto | Explicación |
|---|---|
| Conflictos | Reglas que compiten entre sí generan efectos inesperados — manténgalas coherentes. |
| Previsibilidad | Nombre y documente cada regla; la automatización opaca es un riesgo. |
| Alcance | Las reglas valen para la instancia; revise el impacto antes de activar. |
| Auditoría | El historial permite investigar por qué algo fue (o no) ejecutado. |
Buenas prácticas
- Empiece por pocas reglas de alto impacto (enrutamiento y prioridad).
- Nombre y documente cada regla — los futuros administradores lo agradecerán.
- Pruebe antes de activar; monitoree las primeras ejecuciones.
- Revise reglas que conflictúan o que ya no se disparan.
- Use el diseñador visual solo cuando la complejidad lo justifique.
Errores comunes
| Situación | Qué hacer |
|---|---|
| Ticket enrutado mal | Revise la condición y conflictos entre reglas. |
| Regla “fantasma” | Revise el historial de ejecuciones y el estado (activa/inactiva). |
| Automatización opaca | Documente; sin claridad, se convierte en deuda técnica. |
Preguntas frecuentes
¿La automatización sustituye al operador?
No — quita lo repetitivo y libera al equipo para lo que exige criterio.
¿Puedo probar antes de activar?
Sí, con prueba/dry-run cuando esté disponible.
¿Cómo sé lo que hizo la regla?
Por el historial de ejecuciones.
Automatice vía API
Las reglas están expuestas por API (/api/automacao y logs de ejecución). Referencia en developer.nyverra.com.
Escenarios de uso: qué automatizar primero
1. Enrutamiento automático. Ticket con categoría “Red” va directo al grupo de Red — sin clasificación manual. Es la automatización de mayor impacto, porque ataca el cuello de botella diario del service desk.
2. Prioridad y SLA. Urgencia “Crítica” aplica SLA prioritario y notifica al gestor. La regla garantiza que lo crítico nunca sea tratado como rutina.
3. Flujo de aprobación. Solicitud de acceso inicia automáticamente las etapas de aprobación, ahorrando al solicitante “descubrir el proceso”.
4. Higiene operacional. Tickets detenidos reciben recordatorio; estado “esperando cliente” pausa el SLA y avisa al solicitante.
KPIs de automatización
| Indicador | Qué revela |
|---|---|
| Reglas activas | Nivel de automatización |
| Ejecuciones por período | Uso real de las reglas |
| Reglas sin ejecución | Automatización “muerta” |
| Conflictos/errores de regla | Precisión de las condiciones |
Automatización con criterio
El mayor riesgo de la automatización es la opacidad: reglas que actúan sin que nadie entienda por qué. Mitíguelo con nombres claros, documentación, prueba antes de activar y monitoreo del historial de ejecuciones. Empiece por pocas reglas de alto impacto, mida el efecto y expanda. Así, la automatización reduce el trabajo manual sin ocultar lo que está sucediendo bajo el capó — lo que es la única manera de que sea confiable a largo plazo.
Checklist de automatización
- Identifique tareas repetitivas.
- Cree reglas de alto impacto primero.
- Pruebe antes de activar.
- Monitoree el historial de ejecuciones.
- Revise conflictos entre reglas.
- Documente cada regla.
Preguntas frecuentes adicionales
¿La automatización sustituye al operador?
No; quita lo repetitivo y libera al equipo.
¿Cómo saber por qué algo fue enrutado?
Por el historial de ejecuciones de las reglas.
¿Puedo apagar una regla sin borrarla?
Sí, usando activar/desactivar.
Conclusión
Con Automatización, el Portal Nyverra ITSM trabaja 24/7 enrutando, priorizando y comunicando. Hecha con criterio — reglas claras, probadas y monitoreadas — reduce el trabajo manual y deja que el equipo se enfoque en lo que realmente necesita personas.
Seguir leyendo
Lea también
 Tutoriais
Manual LSI / Broadcom MegaRAID — MegaCli y StorCLI
Con esta guía, su equipo gana autonomía para diagnosticar rebuilds, resolver foreign configurations, gestionar BBU y CacheCade — con escenarios reales de producción documentados.
20 min de leitura
Nginx Cheatsheet
Guía de bolsillo con ejemplos listos para configurar Nginx en producción: desde instalación y virtual hosts hasta ajuste de rendimiento y resolución de problemas.
12 min de leitura Kubernetes
Curso Kubernetes 27 — SLO/SLI, on-call y postmortem sin culpa
Qué prometer, cómo medir y qué hacer cuando el error se dispara: SLI, SLO, presupuesto de error, alertas que despiertan a alguien y postmortem sin caza de brujas.
5 min de leitura
Comentarios
Aún sin comentarios
Sea el primero en compartir su opinión sobre este artículo.


Deje un comentario